Nuestra visión
Una inteligencia que aprende de la experiencia y sabe cuándo necesita más evidencia.
Una memoria que acompaña al robot
Imagina un dron que inspecciona una instalación y vuelve otro día. En lugar de empezar desde cero, puede recordar lo que observó y usar esa experiencia para preparar su siguiente visita.
Esa es la idea detrás de ECHO-Core: una memoria pequeña, persistente y comprensible que funciona en CPU, sin necesitar un modelo de lenguaje ni una API en cada decisión. Queremos que las observaciones, decisiones y resultados permitan entender qué hizo el robot y por qué.
Flight Lab utiliza PX4 para el vuelo y Gazebo para la simulación; ECHO aporta el adaptador que decide exploración y retorno con memoria. La oportunidad no está en simular un dron, sino en aprovechar la experiencia entre misiones.
Lo que hemos visto
En una primera integración, el dron cargó memoria de un vuelo compatible, reconoció sectores familiares y omitió tres pausas de inspección. Visitó tres de cuatro puntos antes de regresar. Sin memoria también visitó tres; una caché sencilla alcanzó cuatro.
Fue una ejecución por condición. Nos sirve para ver la idea funcionando, pero todavía no demuestra que ECHO sea mejor. Queremos compararlo con cachés y planificadores competentes, midiendo tiempo, cobertura y seguridad en más misiones.
Un modelo que puede decir «no lo sé»
ECHO-LLM parte de una idea sencilla: el modelo interpreta y propone; ECHO comprueba lo que puede comprobar, conserva la evidencia y permite abstenerse cuando falta información.
Imagina un asistente que consulta un contrato: encuentra el documento, interpreta la pregunta y comprueba que la respuesta corresponde al contrato y a la fecha solicitados. Si falta el dato, responde que no lo sabe. Es una utilidad que buscamos y que aún debemos probar con documentos reales.
La visión es combinar modelos sobre bases abiertas con memoria y comprobaciones deterministas. La organización prevista parte de un director que reparte el objetivo entre equipos, cuyos agentes ejecutan tareas concretas. Los modelos propios y esta coordinación todavía están por demostrar.
Una organización de IA
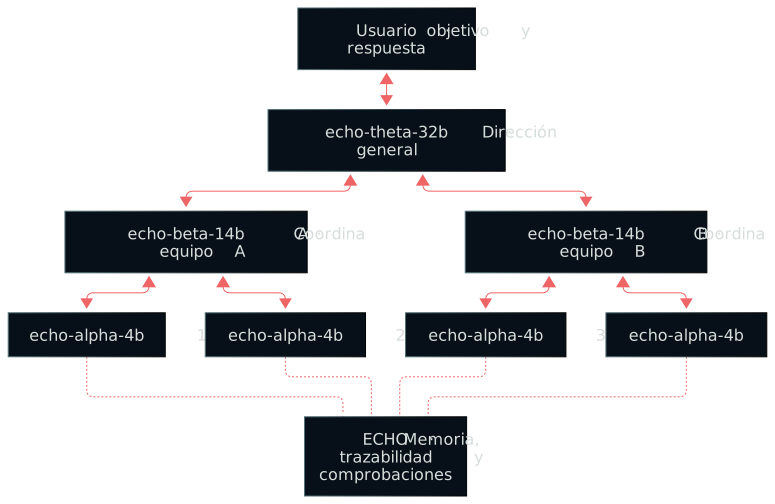
El usuario plantea un objetivo a echo-theta-32b, el director general. Este coordina a dos echo-beta-14b, y cada uno dirige a dos echo-alpha-4b: siete agentes en una jerarquía 1→2→4. Los 14B organizan el trabajo y los 4B ejecutan tareas concretas que podrían realizarse en paralelo, según los recursos disponibles.
Los resultados vuelven hacia arriba: cada 4B informa a su 14B, los responsables sintetizan sus hallazgos y el 32B responde al usuario. Una dificultad también puede elevarse al responsable. Son roles previstos; no implica mantener siete modelos cargados a la vez.
El núcleo ECHO sería el soporte común de memoria, trazabilidad y comprobaciones para la información y las acciones que tengan reglas definidas. El lenguaje humano aportaría contexto y matices entre modelos; WSP transportaría estado y referencias estructuradas. Una propuesta de otro agente no se convertiría en un hecho verificado solo por circular por el equipo.
Por ejemplo, al analizar contratos, un 14B podría coordinar la revisión de fechas y otro la de condiciones. Cada uno repartiría documentos entre sus dos 4B y devolvería una síntesis al director.
La ventaja por demostrar es hacer mejor el trabajo, o mejorar la relación entre calidad, tiempo y coste, frente a un 32B solo y controles más sencillos. Esta jerarquía es una visión futura, no el sistema evaluado en F3. F4 probará primero una versión pequeña: un 14B y dos 4B, comparados con modelos solos y un enrutador fijo.
Una primera señal
En el examen sintético F3, Qwen3-4B con ECHO redujo las respuestas falsas del 31,25 % al 0 % observado en 1.200 casos sin respaldo. El filtro conservó 594 de los 597 aciertos de la base en 600 preguntas respondibles.
Es una señal alentadora en un banco concreto. La mayor parte de la mejora vino de conectar la respuesta con la pregunta correcta; WSP/CAM no mostró una ventaja adicional clara sobre un control textual, y un programa sin LLM obtuvo mejor puntuación agregada. Necesitamos repetir la comparación con tareas y textos menos artificiales, midiendo también abstenciones, latencia y coste.
Lo que queremos conseguir
Queremos que robots y modelos pequeños sean más útiles con recursos contenidos: recordar experiencias, justificar decisiones y reconocer cuándo no tienen evidencia suficiente. La memoria, la ejecución local y la delegación también existen en otros sistemas; nuestra contribución tendrá que demostrarse en comparaciones rigurosas.
Seguimos investigando cómo coordinar modelos, verificar sus resultados y aprender de la experiencia. Cada capacidad deberá ganarse su lugar con resultados medibles.
Buscamos personas que quieran investigar y desarrollar con nosotros, e inversión para impulsar esta investigación.