ECHO-LLM
Lenguaje con memoria. Evidencia antes de responder.
ECHO-LLM conecta el razonamiento de un modelo de lenguaje con el núcleo ECHO. El modelo recibe preguntas y contexto en lenguaje humano; WSP conserva la evidencia estructurada que el sistema puede comprobar.
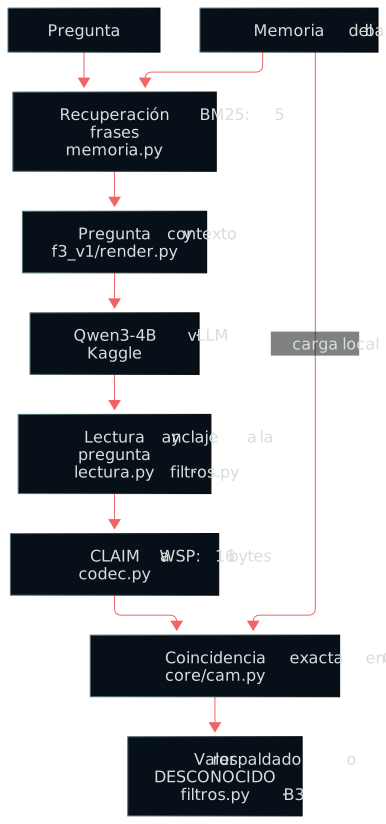
En F3 se utilizó Qwen3-4B, sin ajuste fino, junto a ECHO 5.8.3. El modelo propone una afirmación y el núcleo comprueba que responde a la pregunta y coincide con un hecho de la memoria. Cuando falta respaldo, el sistema se abstiene.
Estructura del código
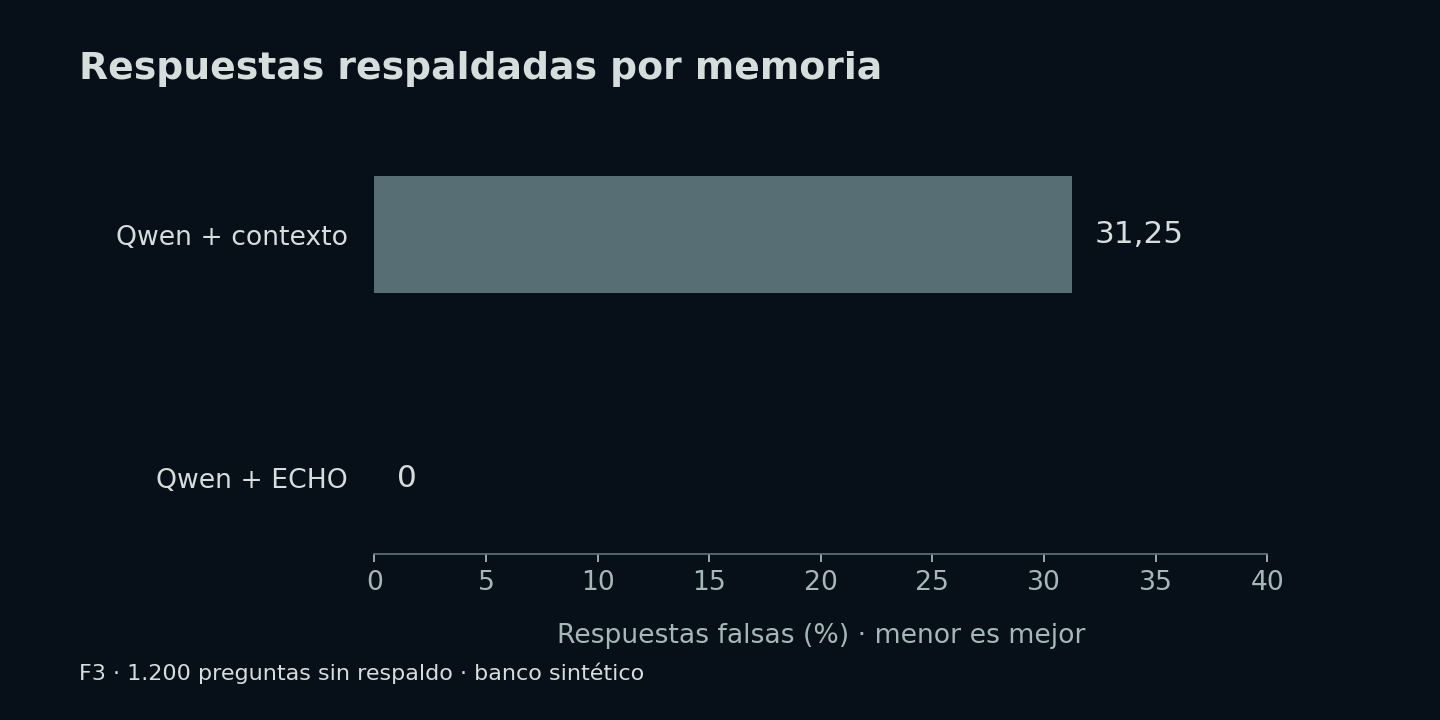
- 31,25 % → 0 %
- Respuestas falsas observadas en 1.200 preguntas sin respaldo.
- 594 de 597
- Aciertos de la base conservados por el filtro, entre 600 preguntas respondibles.
- 0 de 1.000
- Falsos aceptados en los ataques del examen.
F0 · base consolidada
Núcleo y evidencia organizados en una base reproducible para las evaluaciones de ECHO-LLM.
F1 · diseño revisado
El diseño superó una revisión independiente. Se comprobó la representación WSP con 200.005 casos de ida y vuelta y se fijaron las condiciones de verificación.
F2 · verificador validado
21 de 21 pruebas deterministas superadas. Con respuestas oráculo, el verificador conservó el 100 % de los casos respondibles de desarrollo y se abstuvo correctamente en los casos sin respaldo previstos por el banco.
F3 · examen superado
3.000 preguntas y 9.000 generaciones con Qwen3-4B. Se cumplieron las tres condiciones del examen: reducir respuestas falsas, conservar los aciertos y resistir los ataques definidos.
Examen F3: banco sintético en español y memoria definida. B3 aplica el filtro a las mismas respuestas de Qwen con contexto; el modelo no vuelve a generar. Las cifras describen este examen y su comparación con la base.